
سرمایه داری داده و نژادپرستی الگوریتمی
حتی قبل از اینکه همهگیری جهانی به شدت وابستگی خود را به فناوری ارتباطات برای کار، یادگیری، خرید و معاشرت از راه دور افزایش دهد، آمریکاییها از همه اقشار جامعه ناراحتی فزایندهای در مورد تأثیر شرکتهای فناوری بر کشور ما گزارش کردند. خواه این شرکت اقتصاد گیگ باشد که الگوریتمهای تشویقی خود را سرهم میکند – و حقوق هزاران «پیمانکار مستقل» را کاهش میدهد، یا شرکتی که فناوری تشخیص چهره را دستفروشی میکند که بهطور نامتناسبی افراد رنگین پوست را به عنوان مجرمان تحت تعقیب شناسایی میکند، سایت ویدیویی که اطلاعات نادرست تحریکآمیز را ترویج میکند که تضمین میکند کلیکها ایجاد کند، یا غول رسانههای اجتماعی که به تبلیغکنندگان اجازه میدهد خریداران خانه سیاهپوست را از دیدن آگهیهای املاک در محلههای خاص محروم کنند، جامعه در سراسر کشور با اثرات استخراج دادههای غیرقابل پاسخگویی* و تصمیمگیری الگوریتمی دست و پنجه نرم میکنند. نگرانیها بسیار فراتر از نگرانی در مورد حریم خصوصی شخصی به سؤالات اساسی قدرت و کنترل است. این مقاله نشان میدهد که محرک اصلی سرمایهداری داده است : یک مدل اقتصادی که بر اساس استخراج و کالاسازی دادهها و استفاده از دادههای بزرگ و الگوریتمها بهعنوان ابزارهایی برای تمرکز و تثبیت قدرت به روشهایی که بهطور چشمگیری نابرابری را در امتداد خطوط نژادی افزایش میدهد، ساخته شده است. طبقه، جنسیت و ناتوانی
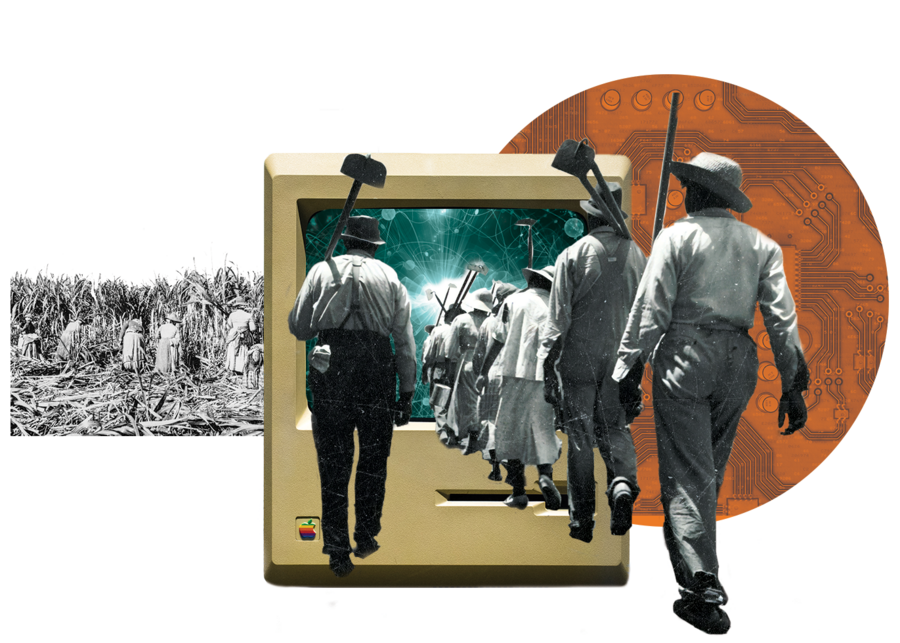
در هسته خود، نابرابری نژادی یکی از ویژگی های سرمایه داری داده است، نه یک اشکال. در واقع، کلان داده آنطور که معمولاً تصور می شود جدید یا انقلابی نیستند. درعوض، این بخشی از میراث تاریخی طولانی و فراگیر و جدول زمانی تکنولوژیک سرکوب علمی، سیاست عمومی تهاجمی، و تأثیرگذارترین نظام سیاسی و اقتصادی است که اقتصاد این کشور را شکل داده و ادامه میدهد: بردهداری کلبهای. نژادپرستی الگوریتمی زمانی اتفاق میافتد که شیوههای دادههای بزرگ معاصر نتایجی را ایجاد میکنند که نابرابریهای نژادی را بازتولید و گسترش میدهند و قدرت و کنترل را از افراد و جوامع سیاهپوست و قهوهای تغییر میدهند.
هدف این گزارش کمک به سیاستگذاران، رهبران جنبش و متفکران است تا چالشهای ناشی از سرمایهداری دادهها و راههایی که اساساً با نژادپرستی سیستمی در هم آمیخته است، بهتر درک کنند و به آنها رسیدگی کنند. این گزارش مشکل اصلی سرمایهداری دادهها را توصیف میکند، ریشههای آن را در تاریخ بررسی میکند، و به طور مختصر چگونگی تجلی آن امروزه در محل کار، بازار مصرف، و حوزه عمومی را بررسی میکند. ما نشان میدهیم که سیستم در حال تحول سرمایهداری دادهها نتیجه اجتنابناپذیر پیشرفت فناوری نیست، بلکه نتیجه تصمیمگیریهای سیاستی است. این مختصر تغییر سیاست های کلیدی مورد نیاز برای اطمینان از اینکه ابزارهای فناورانه قدرتمند دیگر قدرت ساختار قدرت شرکتی تحت سلطه سفیدپوستان را متمرکز نمی کند، بلکه در راه هایی استفاده می شوند که برای زندگی سیاه پوستان مفید است را برجسته می کند. ما می دانیم که وقتی زندگی سیاه واقعاً مهم باشد، همه سود خواهند برد. در نهایت، ما با نگاهی به گروههایی که برای به چالش کشیدن سرمایهداری دادهای بسیج میشوند، نتیجهگیری میکنیم و به وضوح نشان میدهیم که مسیر کنونی ما اجتنابناپذیر نیست.
*لطفاً برای تعاریف اصطلاحات فناوری به واژه نامه انتهای این گزارش مراجعه کنید. کلماتی که در واژه نامه تعریف می شوند، اولین باری که در متن ظاهر می شوند پررنگ هستند.
سرمایه داری داده چیست؟
این گزارش از اصطلاح «سرمایهداری دادهها» برای توصیف یک مدل اقتصادی مبتنی بر استخراج و کالاییسازی دادهها و استفاده از دادههای بزرگ و الگوریتمها به عنوان ابزاری برای تمرکز و تثبیت قدرت به روشهایی استفاده میکند که بهطور چشمگیری نابرابری را در امتداد خطوط نژاد، طبقه، افزایش میدهد. جنسیت و ناتوانی
سرمایهداری دادهای با عباراتی مانند «سرمایهداری نظارتی» در تشخیص آن تفاوت دارد که مشکل اصلی خود فناوری نظارتی نیست، بلکه روشهایی است که فناوری برای تقویت نابرابریهای قدرت از قبل موجود به کار میرود. این گزارش بهویژه بر تفاوتهای قدرت نژادی و اقتصادی و بررسی اینکه چگونه سرمایهداری دادهها ریشه در بردهداری و برتری سفیدپوستان دارد، تمرکز میکند، حتی وقتی میدانیم که سرمایهداری و برتری سفیدپوستان با دیگر اشکال سلطه، از جمله پدرسالاری (دگرگون)، هنجارگرایی مشترک متقابل هستند. ، استعمار شهرک نشینان و توانایی گرایی.
مشکل سرمایه داری داده
استفاده از داده ها و سیستم های اطلاعاتی برای انقیاد و کنترل سابقه ای طولانی دارد. عنصر جدید این است که چگونه شرکت ها قابلیت های فن آوری جدید را به روش هایی به کار می گیرند که روندهای موجود را تشدید و تسریع می کند. اولین مؤلفه، نظارت همه جا حاضر است. شرکتهای فناوری مانند گوگل و فیسبوک خدمات آنلاین ظاهرا رایگان ارائه میکنند در حالی که به طور کامل بر فعالیت آنلاین کاربران نظارت میکنند: هر جستجو، «لایک»، پیوند کلیک شده، و خرید کارت اعتباری. ردیابی موقعیت مکانی بیدرنگ توسط تلفن همراه و نظارت با دستگاههای هوشمند – از بلندگوها گرفته تا زنگ درها و ترموستاتها و ماشینها – امکان جمعآوری اطلاعات شرکتی به صورت آفلاین را نیز فراهم میکند. دوربینهای نظارت عمومی و خصوصی و افزایش نظارت کارفرما بر فعالیتهای آنلاین کارگران، ایمیل، حرکات و فعالیتهای خارج از محل کار، به نظارت فراگیر و استخراج بیسابقه دادههای شخصی، اغلب بدون آگاهی مردم کمک میکند. دادهها زمانی که فروخته میشوند و مجدداً فروخته میشوند، کسب درآمد میشوند، و الگوریتمها برای جمعآوری دادهها از منابع مختلف برای ایجاد تصویری با جزئیات فزاینده از عادات و ترجیحات شخصی استفاده میشوند، که شرکتها از ابزارهای پیشبینیکننده استفاده میکنند که نتایج آینده را مدلسازی میکنند و دستهبندی، امتیازات و رتبهبندی را تولید میکنند. .
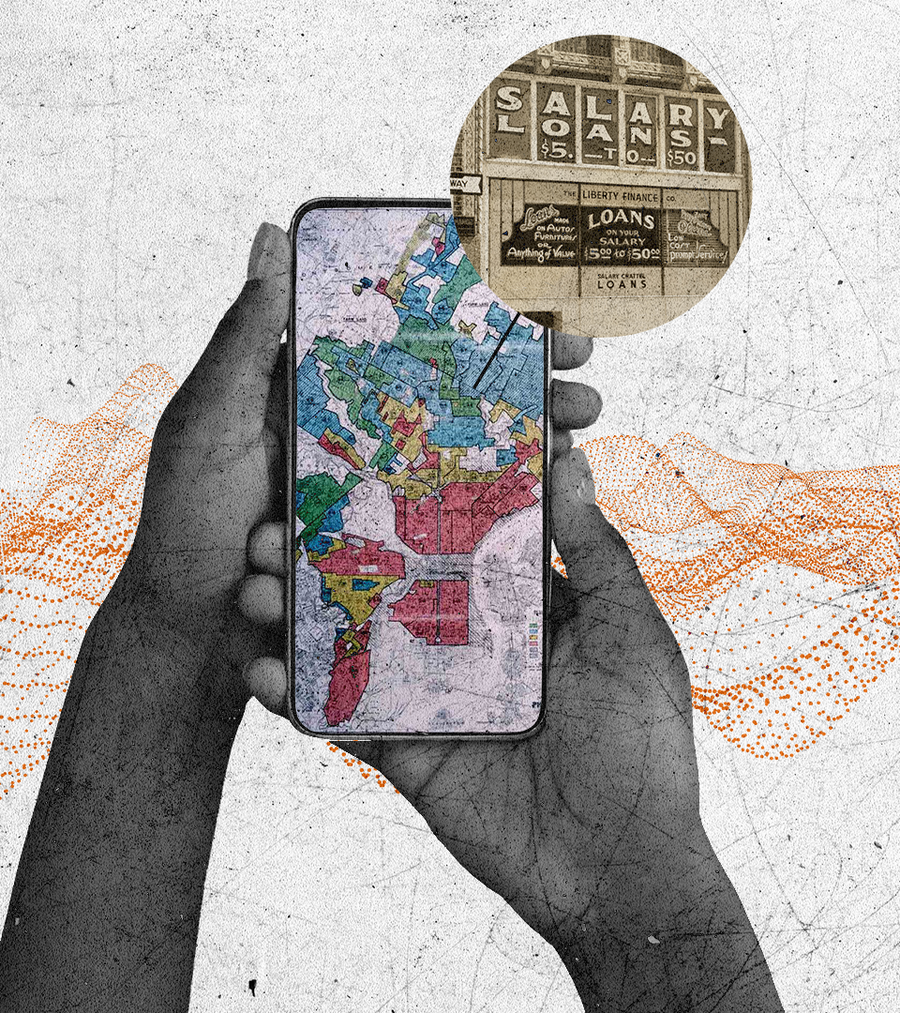
دادههای بزرگ نه تنها برای فروش تبلیغات هدفمند، بلکه برای اتخاذ مجموعهای از تصمیمات خودکار پرمخاطره در مورد اشتغال، سرمایهگذاری، وامدهی و قیمتگذاری در حوزه خصوصی و تصمیمات متعاقب دولت در حوزههایی از جمله عدالت کیفری، آموزش و پرورش و… استفاده میشود. دسترسی به منافع عمومی
ابزارهای فنآوری فرآیند استخراج دادهها و استفاده از مرتبسازی و رتبهبندی الگوریتمی را برای دستهبندی و ارزیابی افراد از نظر «شایستگی» برای دسترسی به همه چیز، از شغل جدید گرفته تا وام مسکن و پوشش مراقبتهای بهداشتی تحت Medicaid، تقویت میکنند. الگوریتمها عمدتاً توسط برنامهنویسان مرد مرفه، سفیدپوست و بر اساس دادههای آموزشی که نابرابریهای موجود اجتماعی را منعکس میکنند، طراحی میشوند. برای مثال، کارفرمایی که میخواست کارکنان را برای مدت طولانیتری حفظ کند، دریافت که فاصله از محل کار مهمترین متغیر مرتبط با مدت زمان ماندن کارگران با کارفرما است. با این حال، به دلیل الگوهای پایدار تفکیک مسکونی مبتنی بر میراث تبعیض و خط قرمز، این نیز عاملی بود که به شدت با نژاد همبستگی داشت. بدون پرداختن به نابرابریها و بیعدالتیهای اساسی، تصمیمهای خودکار مبتنی بر الگوریتمها، افراد را در برابر هنجارهای غیرمتناسب سفیدپوست، مرد، توانا، طبقه متوسط یا ثروتمند آمریکایی ارزیابی میکند که بهعنوان جهانی و بیطرفانه به تصویر کشیده میشود. این “نگاه رمزگذاری شده” است، اصطلاحی که توسط محقق و هنرمند جوی بولاموینی برای توصیف “سوگیری الگوریتمی که می تواند منجر به طرد اجتماعی و اعمال تبعیض آمیز شود” ایجاد شده است. همانطور که فعال حمید خان مشاهده می کند، این “نژادپرستی درون نژادپرستی است.”
با این حال، از آنجا که رتبهبندیها و دستهبندیهای عددی توسط الگوریتمهای رایانهای که بر روی مجموعههای داده بزرگ طراحی میشوند، تولید میشوند، اغلب بهعنوان عینی و بیطرفانه ارائه میشوند و پوششی از مشروعیت علمی به تصمیمهایی ارائه میدهند که نژادپرستی و سایر اشکال بیعدالتی را تقویت و تداوم میبخشند. استفاده از تظاهر علم برای عقلانی کردن نژادپرستی یک ترفند فرسوده است که به قرن نوزدهم بازمیگردد، زمانی که ایدههای بیاعتباری از فرنولوژی و قیافهشناسی به کار گرفته شد تا ادعا شود که تفاوتهای زیستی «فطری» تبعیض و نابرابری اجتماعی ناشی از آن را توجیه میکند. همان پویایی نابرابری تشدید شده با نمای علمی امروز در محل کار، بازار مصرف و در حوزه عمومی خود را نشان می دهد.
مشکل اصلی تنها نقض حریم خصوصی شخصی نیست، بلکه اختلاف قدرت عظیمی است که در سیستم ایجاد شده است: در حالی که نظارت و استخراج دادهها تمام جزئیات زندگی افراد را آشکار میکند، الگوریتمهای مورد استفاده برای ارزیابی افراد و تصمیمگیریهایی که عمیقاً بر شانس زندگی تأثیر میگذارند. مخفی نگه داشته می شوند و از چالش یا سوال در امان هستند.
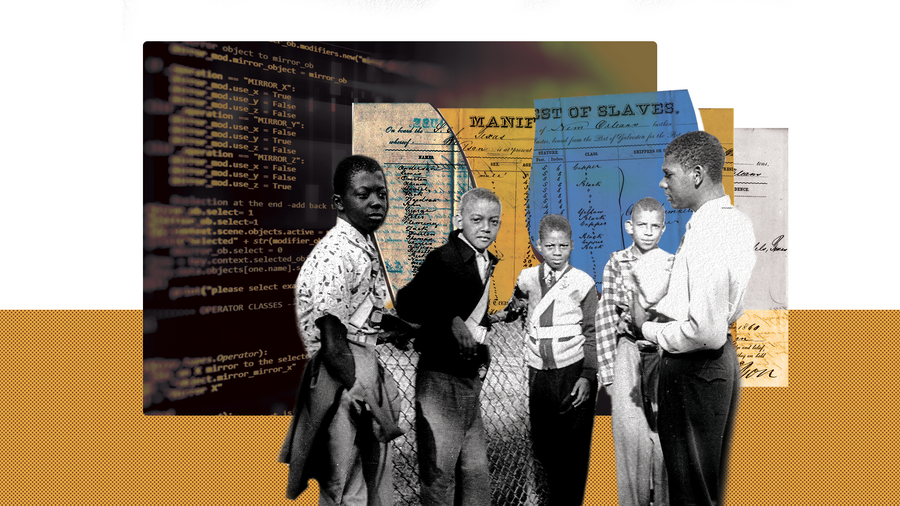
این عدم تقارن اطلاعاتی شدید، قدرت را در دست شرکتهایی که دادهها و الگوریتمها را کنترل میکنند، تثبیت میکند و باعث تعمیق بیشتر نابرابری موجود میشود. در این بخش از مقاله، ما ریشههای سرمایهداری دادهای را در بردهداری خانهای و تکامل آن در طول زمان دنبال میکنیم و پیامدهای مخرب آن را در محل کار، بازار مصرف و حوزه عمومی بررسی میکنیم.
الگوریتم چیست؟
الگوریتم مجموعه ای از دستورالعمل ها برای حل یک مسئله یا انجام یک کار است. به عنوان مثال، دستور العمل ها الگوریتم هایی هستند: فهرستی از دستورالعمل ها یا فرآیندی برای آماده کردن ظرف، مواد تشکیل دهنده ظرف و نتیجه. اما در درون مشکلی که میخواهیم حل کنیم یا کاری که میخواهیم انجام دهیم، تصمیماتی در مورد بهینهسازی برای چیزی است. با دستور غذای خود، آیا میخواهیم روی درست کردن یک وعده غذایی سالم تمرکز کنیم یا یک غذای خوشمزه بدون در نظر گرفتن فواید سلامتی؟ این نشان می دهد که ما چگونه به دنبال دستور غذا هستیم، تصمیم داریم از کدام دستور العمل استفاده کنیم و چه تغییراتی ممکن است انجام دهیم. الگوریتمها میتوانند سطوح مختلفی از پیچیدگی و پیچیدگی داشته باشند، و همیشه به این سادگی نیست که دادههای خام به الگوریتم داده میشوند و خروجیهایی مانند امتیازها، نسبتها، مسیرهای GPS و توصیههای Netflix، برای مثال، وارد میشوند. تاریخچه و ارزش ها در نهایت بر ورودی ها و خروجی ها تأثیر می گذارند. در فرمولهای ریاضی الگوریتم، که با خطوط کد نشان داده میشود، میراث سیاستهای عمومی نژادپرستانه و تبعیض به زمان پایهگذاری این کشور برمیگردد که از طریق مجموعههای دادههای موجود به گونهای مدون شدهاند که گویی مصنوعات دیجیتالی گذشته هستند. دانشمندان داده، فعالان و متخصصان اظهار کرده اند که هیچ الگوریتمی خنثی نیست و الگوریتم ها نظراتی هستند که در کد جاسازی شده اند.

 18